담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
장애 때 필요한 로그만 찾는 법, trace_id 활용 가이드
결제 장애 알림을 받고 로그를 열었습니다. ‘결제 실패’라는 에러는 찾았지만, 그 요청이 어디를 거쳤고 어느 단계에서 문제가 생겼는지는 한 줄만으로 알기 어렵습니다. 장애 시각으로 검색 범위를 좁혀도 다른 주문의 로그가 함께 나옵니다.
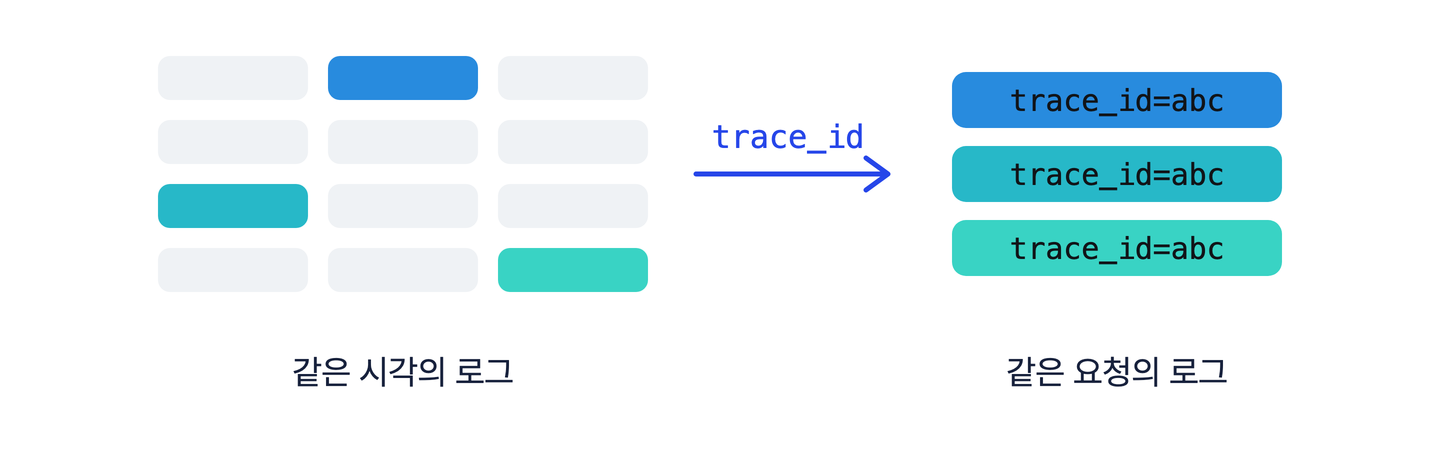
같은 요청의 로그만 골라내려면 로그마다 어느 요청에서 나온 기록인지 표시가 있어야 합니다. 이 표시가 trace_id입니다. APM이나 분산 추적 도구는 요청이 들어올 때 고유한 번호를 하나 붙입니다. 요청이 주문 서비스에서 결제 서비스로 넘어갈 때도 같은 번호를 함께 넘깁니다.
서비스마다 로그에 trace_id를 함께 남겨 두면, 에러 로그에 찍힌 trace_id 하나로 같은 요청의 로그를 모아 볼 수 있습니다. 로그가 여러 서비스에 흩어져 있어도 마찬가지입니다.
트레이스는 요청 하나가 거친 경로와 작업별 소요 시간을 기록한 것입니다. APM이나 분산 추적 도구는 이 기록을 트레이스 화면으로 보여 줍니다.
이 글은 두 가지를 전제로 합니다. 이런 도구로 요청의 트레이스를 볼 수 있고, 로그에도 trace_id가 이미 남아 있어야 합니다. 로그에 trace_id를 출력하도록 설정하는 방법은 장애 때 필요한 로그를 바로 찾으려면? 로그 설정 가이드에서 다룹니다.
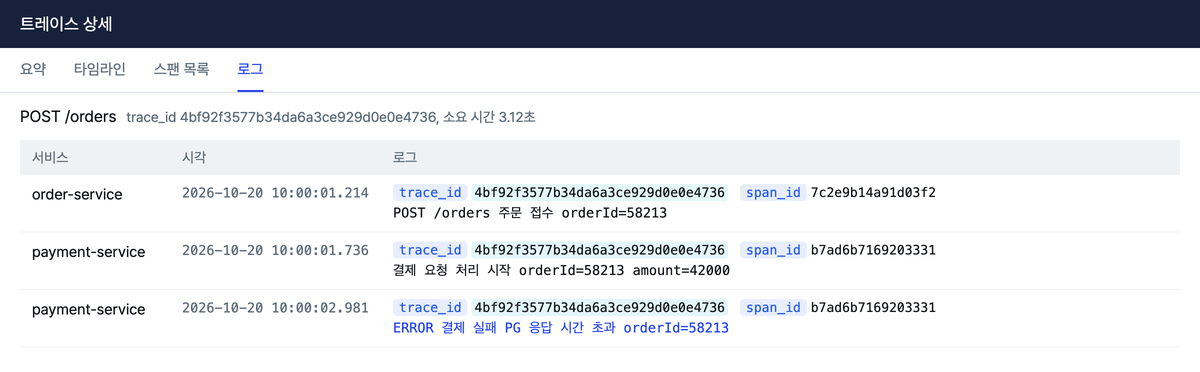
위 화면의 span_id는 요청 안의 작업마다 따로 붙는 번호입니다. 에러 로그에 trace_id가 기록되어 있다면 아래 순서대로 찾을 수 있습니다.
장애 로그를 trace_id로 찾는 순서
출발점은 장애를 처음 발견한 곳에 따라 다릅니다. 트레이스 화면에서 느린 요청을 먼저 봤을 수도 있고, 에러 로그나 알림을 먼저 받았을 수도 있습니다.
트레이스에서 로그로, 느린 요청의 trace_id로 검색하기
트레이스 화면에서는 요청이 어떤 작업을 거쳤고 작업마다 시간이 얼마나 걸렸는지 볼 수 있습니다. 하지만 어떤 값이 처리됐는지, 중간에 재시도나 예외가 있었는지는 애플리케이션 로그를 봐야 알 수 있습니다.
- 트레이스에서 시간이 가장 오래 걸렸거나 오류가 난 작업을 고릅니다
- 트레이스의 trace_id를 복사합니다
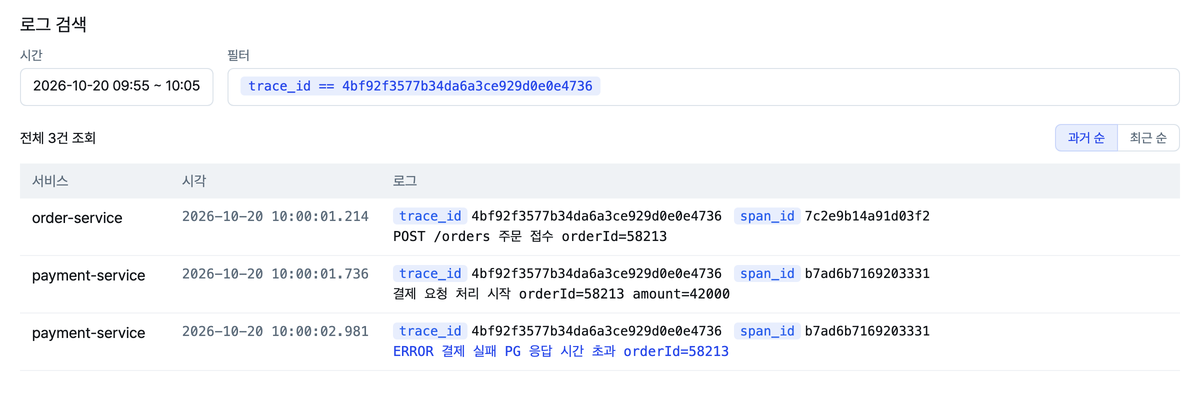
- 로그 검색 화면에서 복사한 값을 trace_id 필드에 입력하고, 요청이 발생한 시각을 포함하도록 검색 범위를 설정합니다
- 결과를 시각순으로 정렬하고 서비스 이름별로 나눠 봅니다
같은 trace_id를 가진 로그는 서비스가 달라도 함께 조회할 수 있습니다. 단, 각 서비스에서 trace_id를 로그에 기록하고 해당 로그가 정상적으로 수집되어 있어야 합니다.
결제 실패 예시라면 주문 서비스의 주문 접수, 결제 서비스의 결제 요청, 결제 실패 에러 로그가 시각순으로 이어집니다. 이 흐름을 따라가면 요청이 어느 서비스의 어느 단계까지 진행됐고 어디서 실패했는지 확인할 수 있습니다.
범위를 더 좁히려면 1단계에서 고른 작업의 span_id로 다시 검색합니다. 그 작업에서 남긴 로그만 남습니다.
span_id로 검색했는데 결과가 없다면 해당 작업에서 로그가 발생했는지 확인합니다. 다른 서비스를 호출하거나 DB 쿼리를 실행한 작업에는 별도의 애플리케이션 로그가 없을 수 있습니다. 예를 들어 결제 서비스 호출 작업에서 로그가 검색되지 않는다면, 결제 서비스에서 요청을 처리한 작업의 span_id로 다시 검색해 봅니다.
로그에서 트레이스로, 에러 로그의 trace_id로 요청 경로 열기
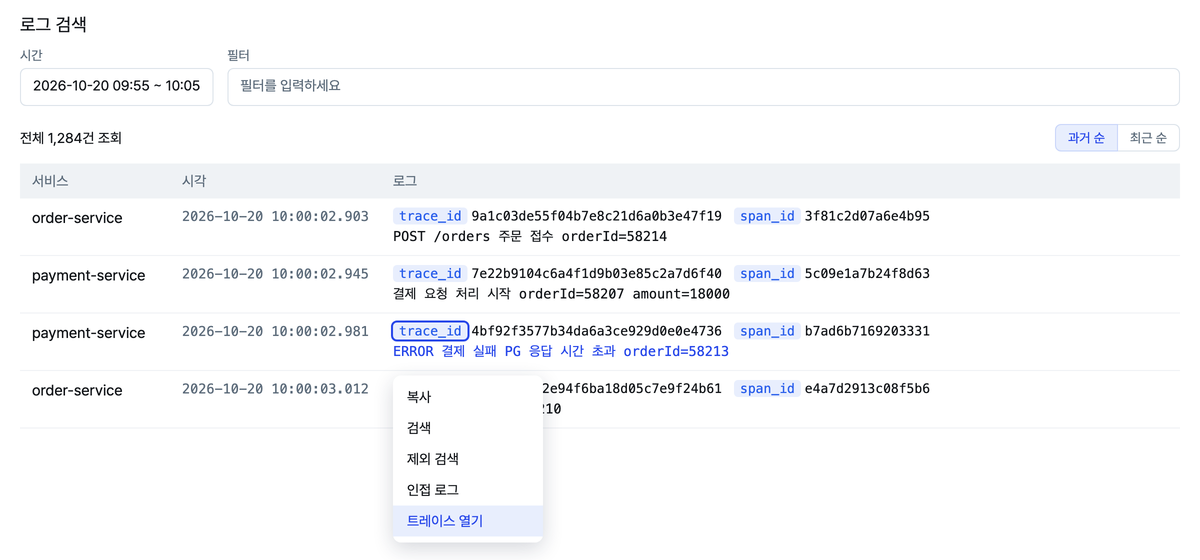
- 에러 로그에 찍힌 trace_id를 복사합니다
- 트레이스 화면에서 trace_id로 검색해 요청의 전체 경로를 엽니다
- 에러가 기록된 서비스만 보지 말고 호출 경로의 앞뒤 서비스까지 함께 봅니다
에러를 기록한 서비스가 원인이 아닐 수도 있습니다. 뒤 서비스가 돌려준 실패를 앞 서비스가 받아 에러로 기록했을 뿐일 수 있기 때문입니다.
특정 서비스 로그만 안 보일 때 점검 순서
trace_id로 검색했는데 특정 서비스의 로그만 보이지 않는 원인은 크게 세 가지입니다.
- 그 서비스가 로그에 trace_id를 기록하지 않습니다
- 그 서비스의 로그가 수집되지 않았습니다
- 앞 서비스가 trace_id를 넘기지 않아, 그 서비스가 새 trace_id로 로그를 남겼습니다
앞의 두 가지부터 확인합니다. 로그에 trace_id 필드가 있는지, 로그 검색에서 그 서비스의 로그가 보이는지 봅니다.
둘 다 문제가 없다면 세 번째 원인을 확인합니다. 서비스 사이에서 trace_id는 traceparent라는 HTTP 헤더에 실려 넘어갑니다. 앞 서비스가 다음 서비스를 호출할 때 이 헤더를 보내는지 살펴봅니다.
Spring Boot에서는 HTTP 클라이언트 객체를 만드는 방식 때문에 헤더가 빠지는 경우가 많습니다. 다른 서비스를 부르는 클라이언트를 Spring Boot가 준비한 Builder 없이 직접 만들면, 헤더를 넣는 트레이싱 설정이 적용되지 않습니다. RestTemplateBuilder, RestClient.Builder, WebClient.Builder로 클라이언트를 만들면 이 문제를 피할 수 있습니다.
trace_id가 아예 비어 있거나 다른 요청의 값이 찍히는 경우는 원인이 다릅니다. 이때는 로깅 설정이나 trace_id를 직접 넣는 코드부터 점검합니다.
트레이스와 스팬 차이, trace_id와 span_id
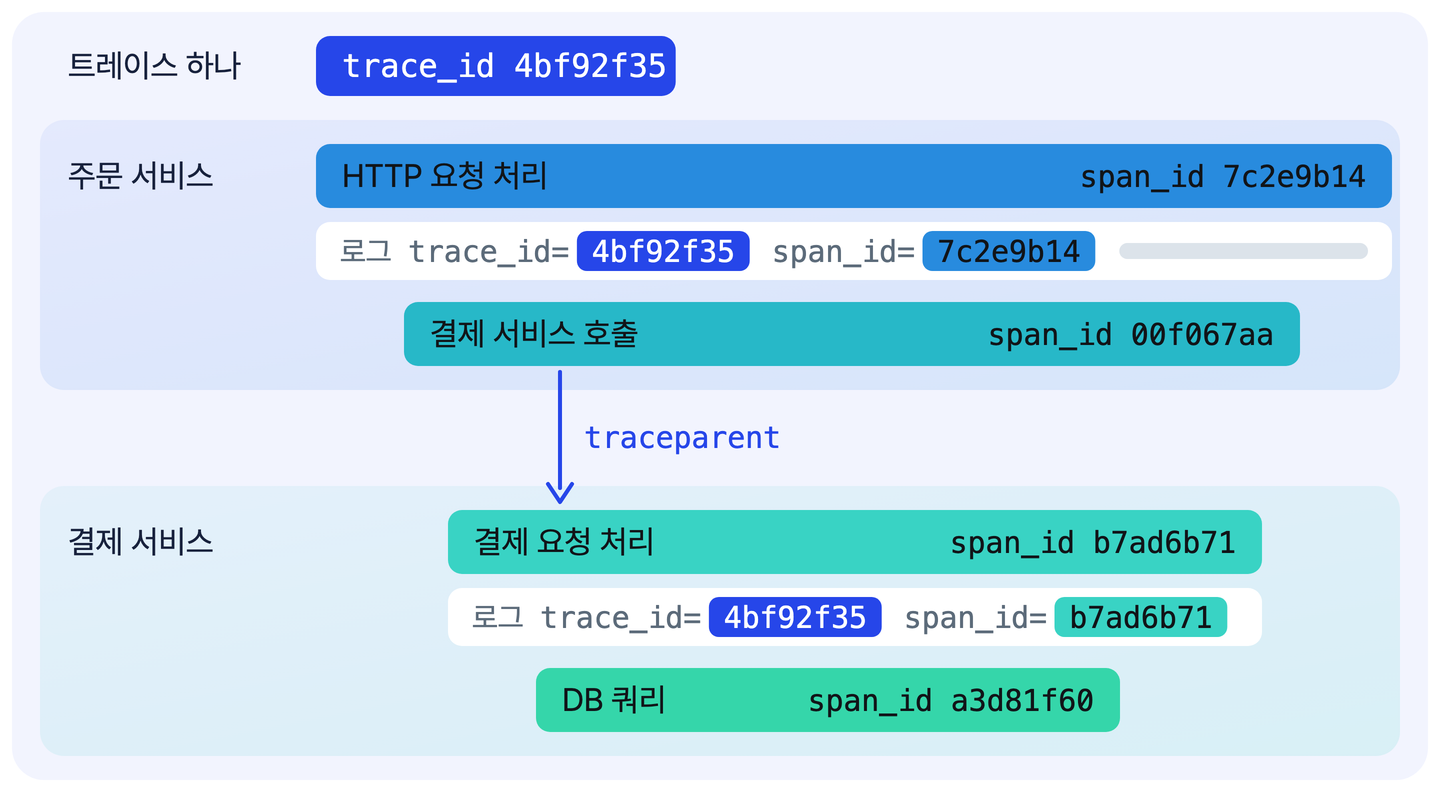
요청 하나가 여러 서비스를 거치는 경로를 기록하는 방식을 분산 추적이라고 합니다. 이때 요청 하나의 전체 경로를 트레이스라고 부르고, 그 안의 작업 단위 하나하나를 스팬이라고 부릅니다. 주문 서비스가 받은 HTTP 요청 처리, 주문 서비스가 결제 서비스를 부른 호출, 결제 서비스의 결제 요청 처리, 결제 서비스가 실행한 DB 쿼리가 각각 스팬입니다.
trace_id는 트레이스 전체에 하나만 붙습니다. 요청이 주문 서비스에서 결제 서비스로 넘어가도 값이 그대로입니다. span_id는 스팬마다 새로 만들어집니다. 그래서 네 작업의 span_id는 모두 다릅니다.
로그에 두 값을 함께 남기면 각각 다른 용도로 쓸 수 있습니다. trace_id로는 같은 요청의 로그를 모읍니다. span_id로는 그 요청의 어느 작업에서 남긴 로그인지 구분합니다. 로그와 트레이스를 이렇게 같은 값으로 잇는 일을 로그와 트레이스 연결, 영어로 log trace correlation이라고 부릅니다.
서비스 사이에 trace_id를 넘기는 방법, traceparent 헤더
trace_id가 요청 전체에서 같은 값으로 유지되려면, 서비스가 다음 서비스를 호출할 때 그 값을 함께 넘겨야 합니다. 이 값을 실어 나르는 HTTP 헤더가 traceparent입니다. 웹 표준 단체 W3C가 정한 Trace Context 표준의 헤더라서, 서로 다른 언어로 만든 서비스끼리도 같은 값을 주고받을 수 있습니다.
헤더는 버전, trace_id, parent-id, trace-flags 네 부분으로 구성됩니다.
맨 앞 두 자리는 형식 버전입니다. 다음 32자리가 trace_id입니다. 이어지는 16자리가 parent-id로, 호출한 쪽 스팬의 span_id입니다. 맨 뒤 두 자리는 trace-flags입니다. 01이면 호출한 쪽이 이 요청을 트레이스 기록 대상으로 표시했다는 뜻이고, 00이면 기록 대상이 아니라는 뜻입니다.
아래 도식은 주문 서비스와 결제 서비스 예시를 트레이스 화면처럼 그린 것입니다. trace_id와 span_id는 앞 8자리만 표시했습니다. 가장 바깥 면이 트레이스 하나입니다. 그 안의 색 막대는 작업이고, 흰 줄은 그 작업에서 남긴 로그입니다. 한 단계 들여 쓴 막대는 바로 위 작업 막대가 실행되는 동안 일어난 작업입니다.
correlation id와 trace_id 차이, 트레이스가 끊길 때 쓰는 값
correlation id는 trace_id처럼 여러 서비스의 로그를 같은 요청끼리 묶는 식별 값으로, trace_id보다 먼저 쓰이던 방식입니다. 두 값의 차이는 값을 다루는 주체입니다. trace_id는 대개 분산 추적을 맡는 트레이싱 도구가 값을 만들고 다음 서비스로 넘겨 줍니다. correlation id를 만들고 넘기는 코드는 팀이 직접 짜는 경우가 많습니다.
correlation id로도 같은 요청의 로그는 모을 수 있지만, 호출 순서와 단계별 소요 시간은 로그 시각을 비교해 추정해야 합니다. trace_id를 쓰면 같은 값으로 트레이스 화면을 열어 바로 확인할 수 있습니다.
correlation id는 보통 이렇게 만들고 넘깁니다. 요청이 처음 들어오는 관문 서버인 게이트웨이나 첫 서비스가 UUID를 하나 만듭니다. UUID는 겹치지 않게 만든 무작위 문자열입니다. 이 값을 X-Request-ID나 X-Correlation-ID 같은 헤더에 실어 다음 서비스로 넘깁니다. 각 서비스는 그 헤더를 읽어 로그에 남깁니다.
trace_id가 이어지지 않는 구간에서는 correlation id나 업무 식별자를 로그에 함께 남겨 같은 요청의 로그를 모읍니다. 업무 식별자는 주문 번호처럼 업무에서 쓰는 값입니다.
trace_id가 끊기기 쉬운 곳은 메시지 큐입니다. 메시지 큐는 처리할 메시지를 잠시 저장해 두었다가 다른 서비스에 넘겨주는 중간 저장소입니다.
주문 서비스가 결제 메시지를 큐에 넣고, 결제 서비스가 나중에 꺼내 처리하는 경우를 생각해 봅니다. 트레이싱 도구가 메시지에 trace_id를 함께 싣지 않으면 주문과 결제가 서로 다른 트레이스로 기록될 수 있습니다. 이때 로그에 주문 번호를 함께 남겨 두면, 트레이스가 달라도 같은 주문의 로그를 모아 볼 수 있습니다.
자주 묻는 질문
trace_id는 어떤 형식인가요
W3C Trace Context 기준으로 trace_id는 16바이트 값을 소문자 16진수 32자리로 씁니다. span_id는 8바이트 값을 16자리로 씁니다.
일부 도구는 값을 대문자로 표시하거나 자체 형식으로 바꿔 저장하기도 합니다. 같은 값인데 검색이 안 된다면 대소문자와 자릿수부터 맞춰 봅니다.
로그에 trace_id는 있는데 트레이스가 없는 이유는 무엇인가요
트레이싱 도구가 그 요청을 샘플링하지 않아 트레이스가 저장되지 않았을 가능성이 큽니다. 샘플링은 저장 비용을 줄이려고 일부 요청만 트레이스로 기록하는 방식입니다. Spring Boot는 기본으로 요청의 10%만 샘플링합니다.
트레이스가 없어도 로그는 모아 볼 수 있습니다. 로그에 trace_id가 기록되고 수집됐다면, 같은 trace_id로 여러 서비스의 로그를 요청 단위로 찾을 수 있습니다.
서버를 켤 때 남는 로그처럼 trace_id가 없는 로그는 어떻게 찾나요
서버를 켤 때 남는 로그처럼 처리 중인 요청 없이 남는 로그에는 trace_id가 없을 수 있습니다. 배치 작업 로그도 배치 작업을 추적하도록 설정하지 않았다면 마찬가지입니다. 이때는 시각과 호스트, 스레드 이름으로 범위를 줄여 찾습니다.
마치며
장애 때 수많은 로그 속에서 문제 요청의 로그만 보려면 trace_id 하나로 검색하는 것이 출발점입니다. 이 검색이 되려면 세 가지가 갖춰져야 합니다. 각 서비스가 로그에 trace_id를 남기고, 그 로그가 수집되고, 다음 서비스로 같은 값이 넘어가야 합니다. 특정 서비스의 로그만 빠진다면 이 순서대로 점검합니다. 로그에 trace_id를 넣는 설정과 비동기 작업에서 값이 빠지는 문제는 이어지는 글에서 다룹니다.
로그에 표준 trace_id 대신 자체 식별자를 남겨 같은 목적을 이루는 APM 제품도 있습니다. 와탭도 그중 하나입니다.
와탭 APM의 Java, Python, Node.js 에이전트는 트랜잭션 아이디(txid)를 로그에 함께 남깁니다. 트랜잭션은 서비스 하나가 요청 하나를 처리한 단위이고, txid는 트랜잭션마다 붙습니다. 그래서 와탭 로그 모니터링에서 트랜잭션에 연결된 로그를 볼 수 있습니다.
Java와 Python 에이전트를 쓰면 로그 검색에서 로그 한 줄을 골라 그 트랜잭션 정보로 이동할 수도 있습니다. 여러 서비스를 거친 요청을 묶는 멀티 트랜잭션 아이디(mtid)도 로그에 남길 수 있습니다. 두 아이디는 trace_id와 같은 값이 아니라, 분산 추적 개념과 같은 역할을 하는 값입니다.
언어별 지원 범위와 로그 연동 설정은 Java, Python, Node.js 로그 모니터링 문서에서 확인할 수 있습니다.
더 읽을거리