담당자가 프로모션 코드를 발송해 드립니다.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
와탭을 경험해 보세요.
WhaTap AI를 경험해 보세요.
OpenTelemetry GenAI 시맨틱 컨벤션과 LLM 옵저버빌리티 표준
새로운 기술이 퍼질 때마다 그 기술을 관측하는 방식은 비슷한 단계를 거칩니다. 처음에는 팀마다 벤더마다 제 방식으로 데이터를 기록하다가, 제각각인 기록 탓에 운영이 번거로워지고 나서야 공통 어휘로 모입니다. HTTP가 그랬고, 분산 트레이싱이 그랬습니다. 3년 전 LLM 애플리케이션을 관측하던 상황도 똑같았습니다. 어떤 곳은 토큰 수를 prompt_tokens로 기록하고, 다른 곳은 input_token_count라고 불렀습니다. 응답 지연을 측정하는 속성명도 제각각이었습니다. 같은 현상을 보면서 서로 다른 이름을 붙이던 초기 인프라 모니터링 시대의 혼선이, AI 영역에서 다시 시작되고 있었습니다.
OpenTelemetry(이하 OTel)가 이름이 제각각인 문제를 풀려고 생성형 AI 분과인 GenAI SIG(Special Interest Group, 특별 관심 그룹)를 만든 것이 2024년 봄입니다. 그로부터 2년 남짓 지난 지금, LLM 호출에 어떤 이름을 붙이고 무엇을 기록할지 정하는 공통 어휘가 빠르게 정리됐습니다. LLM 옵저버빌리티가 무엇이고 왜 필요한지는 LLM 옵저버빌리티란 무엇인가에서 다뤘습니다. 이 글은 OTel GenAI 시맨틱 컨벤션의 현재 상태와 실제로 정의하는 식별자, LLM을 운영하거나 도입을 검토하는 팀이 확인할 점을 1차 출처 기준으로 정리합니다.
OpenTelemetry GenAI 시맨틱 컨벤션은 어떻게 만들어졌나
지금의 GenAI 표준이 앞으로 어떻게 굳어갈지 가늠하려면 OTel 본체의 이력을 먼저 보는 편이 빠릅니다. OTel은 분산 트레이싱의 파편화 문제를 풀려고 OpenTracing과 OpenCensus를 통합한 프로젝트입니다. 2019년 CNCF(Cloud Native Computing Foundation) 샌드박스 프로젝트로 출발해 2021년 트레이스 규격을 안정 단계(Stable)로 확정했고, 같은 해 인큐베이팅 프로젝트가 됐습니다. 이후 메트릭과 로그로 영역을 넓혔고, 2026년 5월에는 졸업(Graduated) 프로젝트가 됐습니다. 그 과정에서 줄곧 지켜 온 설계 원칙이 하나 있습니다. 데이터를 어떻게 수집하느냐가 아니라, 무엇을 어떤 이름으로 기록하느냐를 표준으로 정한다는 것입니다.
무엇을 어떤 이름으로 기록할지 정한 규약이 시맨틱 컨벤션(Semantic Conventions)입니다. HTTP 호출이라면 http.request.method나 http.response.status_code 같은 키가 여기에 해당합니다. 어느 언어, 어느 라이브러리에서 계측하든 같은 의미는 같은 키에 담기로 한 약속입니다.
2023년 9월, LLM 호출용 시맨틱 컨벤션 제안이 커뮤니티에 처음 올라왔습니다. ChatGPT 출시 이후 LLM 애플리케이션이 급증하면서 "이걸 어떻게 관찰할 것인가"라는 질문이 실무에서 쏟아지던 시점과 겹칩니다. 2024년 봄 GenAI SIG가 공식 출범했고, 그해 말 Span, 메트릭, 이벤트 세 가지 데이터에 걸친 GenAI 속성 체계의 윤곽이 잡혔습니다.
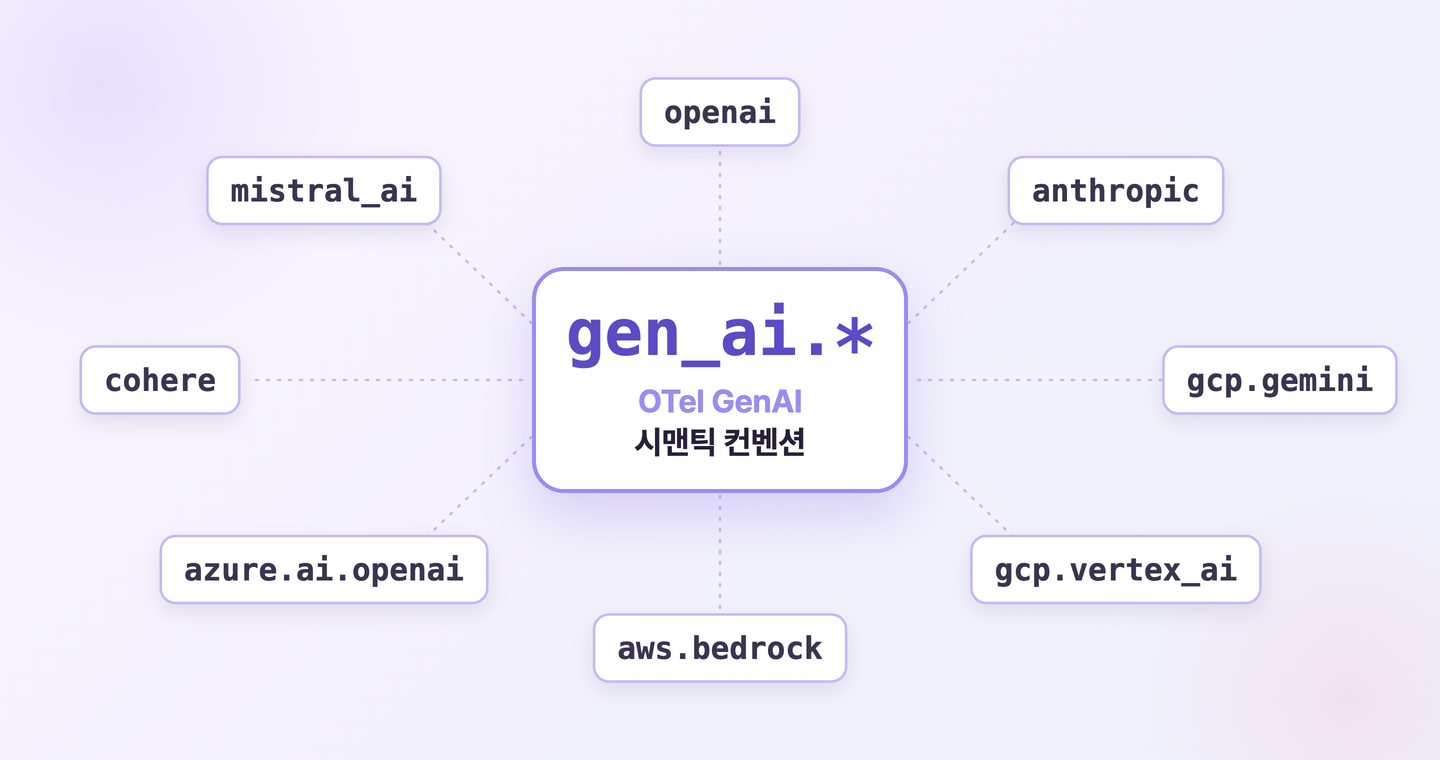
2025년을 지나면서 클라이언트 Span과 메트릭 정의가 대부분 갖춰졌습니다. gen_ai.request.model, gen_ai.usage.input_tokens, gen_ai.client.operation.duration 같은 식별자는 주요 클라우드와 옵저버빌리티 도구가 공통으로 쓰기 시작했습니다. gen_ai 속성을 쓰면 OpenAI든 Anthropic이든 자체 호스팅 모델이든 같은 형태의 관측 데이터로 들여다볼 수 있습니다.
OTel GenAI 표준은 아직 안정 단계가 아니다
도입을 판단할 때는 표준 상태를 먼저 분명히 해 두는 편이 안전합니다. OTel은 2026년 6월부터 GenAI 시맨틱 컨벤션을 본 저장소에서 GenAI 전용 저장소로 옮겨 관리하고 있고, 2026년 10월 기준 등급은 아직 개발 단계(Development)입니다. 키 이름이 바뀔 수 있고, 새 속성이 추가되거나 빠질 수도 있습니다. 실제로 2026년 9월에 토큰 메트릭 이름이 바뀌었습니다. 정식 릴리스 태그 없이 저장소 main에 반영된 변경입니다.
도입 판단은 둘로 나뉩니다. "안정 단계 선언까지 기다린다"가 한쪽, "모여드는 표준을 지금 이해하되 키 변경 가능성은 감안한다"가 다른 쪽입니다. 어느 쪽이 맞는지는 환경에 따라 다르지만, 20년 가까이 관측 영역의 표준이 정착하는 과정을 지켜본 입장에서 보면 한 가지 패턴은 분명합니다. 관측 규약은 공식 안정 선언보다 시장이 먼저 움직이는 경우가 많습니다. 다음 절에서 보듯 주요 플랫폼과 프레임워크는 이미 이 컨벤션을 따라 제품을 만들고 있습니다. 그래서 실무에서는 표준을 지금 익혀 두되 키 이름이 바뀔 여지를 염두에 두는 쪽이 현실적입니다.
클라우드와 에이전트 프레임워크는 OTel GenAI 표준을 받아들이고 있다
표준이 실제로 쓰이는지는 안정 단계 지정 여부보다 도구들이 표준을 얼마나 받아들였는지를 보면 더 분명합니다.
Google Cloud, AWS, Azure 같은 클라우드 제공사가 GenAI 관측 데이터를 OTel GenAI 컨벤션 형식으로 받아들이고 있습니다. AWS의 Strands Agents, Microsoft Agent Framework 같은 에이전트 프레임워크도 OTel GenAI 형식으로 관측 데이터를 내보내는 기능을 제공하고, LangChain, CrewAI 등은 계측 라이브러리로 같은 형식을 지원합니다.
클라우드 제공사와 에이전트 프레임워크는 진영이 다르지만 계측 규약으로는 같은 표준을 사용합니다. 계측 단계에서 특정 벤더의 독자 SDK에 종속되면 나중에 분석 도구를 바꿀 때 수집 코드를 다시 작성해야 하지만, 공통 컨벤션을 따르면 그 작업이 필요 없기 때문입니다.
표준이 다루는 범위도 넓어지고 있습니다. LLM 호출 추적에 더해, 에이전트가 도구를 부르고 메모리를 쓰는 멀티스텝 작업용 값과 에이전트 메트릭도 규격에 추가됐습니다.
OTel GenAI 표준으로 계측하면 무엇이 편해지나
운영자와 의사결정자 관점에서 표준이 주는 실익은 두 가지입니다.
- 도구 교체: OTel 표준 방식으로 LLM 애플리케이션을 계측해 두면, 백엔드 옵저버빌리티 플랫폼을 나중에 바꾸거나 하나 더 붙여도 수집 코드는 그대로 둘 수 있습니다.
- 데이터 병합: 직접 수집한 OTel 트레이스와 벤더 도구의 데이터를 같은 분석 축에서 합칠 수 있습니다.
무엇을 봐야 할지도 더 또렷해집니다. GenAI 시맨틱 컨벤션이 정의하는 관찰 영역은 크게 세 가지입니다.
- 성능: 첫 토큰까지 걸리는 시간(TTFT, Time To First Token), 응답 완료까지의 지연, 요청 지연 분포
- 비용: 입력, 출력, 캐시 토큰 수와 모델별, 호출 유형별 누적량
- 품질: 응답 종료 사유(finish_reasons), 에러 유형, 도구 호출 성공 여부
gen_ai.* 식별자, Span 속성 편
OTel은 LLM 호출 한 건을 Span 하나로 기록합니다. Span 이름 규약부터 봅니다.
Span 이름:
{gen_ai.operation.name} {gen_ai.request.model}예:chat gpt-4o,embeddings text-embedding-3-small
Span에 붙는 속성을 표준에서는 네 단계로 나눕니다. Required(필수), Conditionally Required(조건부 필수), Recommended(권장), Opt-In(민감 데이터, 명시적 동의)입니다. 요구 수준 분류를 보면 도구가 무엇을 항상 보장하고 무엇을 선택적으로 다루는지 가늠할 수 있습니다.
Required, 모든 GenAI Span이 반드시 갖는 두 가지
| 속성 | 의미 |
|---|---|
| gen_ai.operation.name | 어떤 종류의 LLM 호출인가 |
| gen_ai.provider.name | 어느 프로바이더를 호출했는가 |
gen_ai.operation.name의 대표 표준 값으로는 chat, text_completion, embeddings, generate_content, retrieval, execute_tool, create_agent, invoke_agent, invoke_workflow 등이 있고, 에이전트 계획(plan)과 메모리 조회, 저장(search_memory, create_memory 등) 값도 정의돼 있습니다. 단순 추론부터 에이전트 호출, 도구 실행, RAG(Retrieval-Augmented Generation, 검색 증강 생성)의 검색 단계까지 같은 속성 하나로 구분합니다.
gen_ai.provider.name의 표준 값으로는 openai, anthropic, gcp.gemini, gcp.vertex_ai, aws.bedrock, azure.ai.openai, azure.ai.inference, cohere, mistral_ai 등을 정의합니다.
Conditionally Required, 조건을 만족하면 반드시 넣는 속성
| 속성 | 의미 |
|---|---|
| gen_ai.request.model | 요청 시 지정한 모델명 |
| gen_ai.output.type | 요청한 출력 형식 |
| gen_ai.request.choice.count | 응답 후보 수(1이 아닐 때) |
| gen_ai.request.stream | 스트리밍 여부 |
| error.type | 호출 실패 시 에러 분류 |
요청 모델과 응답 모델(Recommended)을 따로 기록하는 이유는 두 값이 다른 경우가 많기 때문입니다. gpt-4o로 요청해도 응답에는 gpt-4o-2024-08-06처럼 구체 버전이 표시됩니다. 모델 라우팅이나 버전별 비교 분석에는 두 속성이 모두 필요합니다.
예를 들어 다음과 같은 Span이 기록될 수 있습니다.
{
  "gen_ai.operation.name": "chat",
  "gen_ai.provider.name": "openai",
  "gen_ai.request.model": "gpt-4o",
  "gen_ai.response.model": "gpt-4o-2024-08-06",
  "gen_ai.usage.input_tokens": 120,
  "gen_ai.usage.output_tokens": 45
}
운영자는 이런 정보를 이용해 모델별 토큰 사용량, 응답 시간, 에러율을 비교할 수 있습니다.
Recommended, 넣어두면 디버깅이 편한 것
| 속성 | 의미 |
|---|---|
| gen_ai.request.temperature, gen_ai.request.top_p, gen_ai.request.max_tokens | 추론 파라미터 |
| gen_ai.response.model | 응답에 표시된 실제 사용 모델 |
| gen_ai.response.id | 응답 식별자(프로바이더 발급) |
| gen_ai.response.finish_reasons | 응답 종료 사유(stop, length, tool_calls 등) |
| gen_ai.usage.input_tokens | 입력 토큰 수 |
| gen_ai.usage.output_tokens | 출력 토큰 수 |
| gen_ai.usage.cache_read.input_tokens | 캐시에서 읽은 입력 토큰 수 |
| gen_ai.usage.cache_write.input_tokens | 캐시에 쓴 입력 토큰 수 |
| gen_ai.usage.reasoning.output_tokens | 추론 토큰 수 |
토큰 수가 Required가 아니라 Recommended에 있다는 점은 처음 보면 의외입니다. 규격에 이유가 나와 있지는 않지만, 프로바이더 응답에 토큰 수가 빠지는 경우가 있기 때문으로 보입니다. 비용을 추적하는 팀이라면 토큰 수를 함께 수집합니다.
캐시와 추론 토큰도 따로 기록할 수 있습니다. 규격상 캐시 토큰은 입력 토큰 수에, 추론 토큰은 출력 토큰 수에 이미 포함되므로 세부 항목을 다시 더하면 중복으로 집계됩니다. 프로바이더 응답을 옮길 때도 주의할 점이 있습니다. Anthropic은 응답의 input_tokens에서 캐시 토큰을 빼고 집계하므로, 규격의 gen_ai.usage.input_tokens에는 input_tokens, cache_read_input_tokens, cache_creation_input_tokens 세 값을 더해 넣어야 합니다. 규격 저장소의 Anthropic 문서도 같은 계산을 안내합니다.
Opt-In, 민감 데이터는 명시적 설정 필요
| 속성 | 의미 |
|---|---|
| gen_ai.system_instructions | 시스템 프롬프트 |
| gen_ai.input.messages | 입력 메시지(채팅 히스토리) |
| gen_ai.output.messages | 모델 응답 본문 |
프롬프트와 응답 본문은 크기가 크고 민감 정보가 섞이기 쉬워서, 운영자가 명시적으로 켤 때만 수집합니다. 보안 검토에서도 Opt-In 속성은 기본 수집에서 빼 두는 편이 안전합니다.
gen_ai.* 식별자, 메트릭 편
같은 LLM 호출을 시계열로 집계하는 메트릭은 따로 정의합니다. 메트릭 키와 Span 속성 키는 들어가는 위치가 다르니 헷갈리지 않게 정리합니다.
| 메트릭 | 타입 | 단위 | 무엇을 보나 |
|---|---|---|---|
| gen_ai.client.inference.usage.input_tokens 외 | Counter | 토큰 | 토큰 누적량(입력, 출력, 캐시, 추론) |
| gen_ai.client.inference.operation.input_tokens 외 | Histogram | 토큰 | 호출당 토큰 분포(입력, 출력) |
| gen_ai.client.operation.duration | Histogram | 초 | 호출 전체 지연 |
| gen_ai.client.operation.time_to_first_chunk | Histogram | 초 | 첫 청크 도착(스트리밍) |
| gen_ai.client.operation.time_per_output_chunk | Histogram | 초 | 청크 사이 간격 |
| gen_ai.server.time_to_first_token | Histogram | 초 | 서버 측 첫 토큰까지 걸린 시간 |
| gen_ai.server.time_per_output_token | Histogram | 초 | 서버 측 토큰당 시간 |
| gen_ai.server.request.duration | Histogram | 초 | 서버 측 전체 처리 시간 |
메트릭 이름의 client는 LLM을 호출하는 애플리케이션 쪽, server는 LLM을 서빙하는 프로바이더 쪽입니다. 자체 호스팅 모델이 아니면 보통 client 메트릭만 수집합니다.
토큰 메트릭은 2026년 9월에 이름이 바뀌었습니다. 예전에는 gen_ai.client.token.usage 히스토그램 하나에 gen_ai.token.type 라벨을 붙여 입력과 출력을 나눴습니다. 지금은 토큰 종류마다 메트릭이 따로 있습니다. 누적량은 gen_ai.client.inference.usage.* 카운터(입력, 출력, 캐시 읽기, 캐시 쓰기, 추론)로, 호출당 분포는 gen_ai.client.inference.operation.* 히스토그램(입력, 출력)으로 기록합니다. 히스토그램은 분포를 보는 용도라 더해서 총량이나 비용을 계산하지 않습니다. 예전 이름으로 만든 쿼리, 대시보드, 알림이 있다면 계측 라이브러리 버전과 함께 확인해야 합니다.
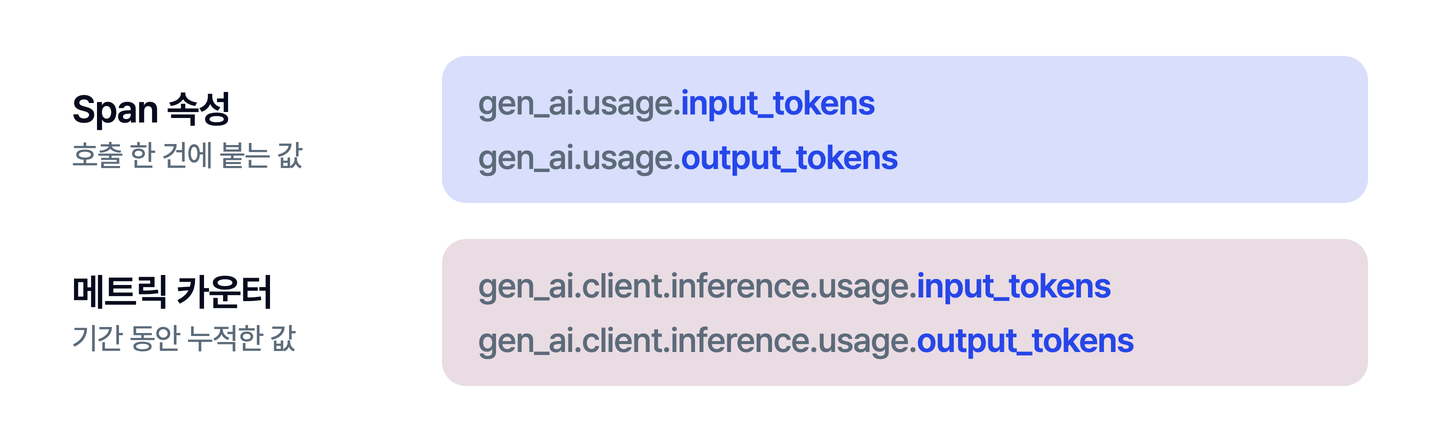 같은 토큰 데이터가 Span에서는 속성 두 개로, 메트릭에서는 카운터 두 개로 들어가고, 이름 끝은 같습니다.
카디널리티, 도입 전에 확인할 한 가지
메트릭을 다룰 때 운영자가 미리 챙겨야 할 함정이 있습니다. gen_ai.request.model이나 gen_ai.response.model처럼 값이 자주 바뀌는 키를 메트릭 라벨로 그대로 쓰면 카디널리티(cardinality, 라벨 조합의 수)가 빠르게 늘어납니다. 모델 버전이 매주 추가되는 환경에서는 모델명 라벨 때문에 메트릭 시계열 수가 급격히 늘어나기 쉽습니다.
표준은 메트릭에도 gen_ai.request.model을 조건부 필수로, gen_ai.response.model을 권장으로 붙이도록 정하고 있어, 모델명이 기본적으로 라벨에 들어갑니다. 수집 도구가 모델명 라벨을 그대로 두는지, 묶거나 걸러 내는지는 제품마다 다릅니다. 도입 검토 단계에서 모델명 라벨 처리 방식을 확인해 두면, 운영 중 메트릭 비용이 예측을 벗어나는 일을 피할 수 있습니다.
운영 관점과 gen_ai.* 식별자 매핑
성능, 비용, 품질을 운영 화면에서 확인할 때 각각 어떤 gen_ai 식별자를 쓰는지 표로 정리했습니다.
| 운영 관점에서 봐야 할 것 | 대표 gen_ai 식별자 |
|---|---|
| 추론 이상과 실패 패턴 | gen_ai.response.finish_reasons, error.type |
| 비용과 토큰 추이 | gen_ai.usage.input_tokens, gen_ai.usage.output_tokens, gen_ai.client.inference.usage.* |
| 응답 지연(TTFT, 토큰당 시간) | gen_ai.client.operation.time_to_first_chunk, gen_ai.client.operation.time_per_output_chunk (자체 호스팅은 gen_ai.server.*) |
| 프롬프트와 응답 본문 보존 | Opt-In 속성(gen_ai.system_instructions, gen_ai.input.messages, gen_ai.output.messages) |
| 모델, 프로바이더, 호출 유형 비교 | gen_ai.request.model, gen_ai.provider.name, gen_ai.operation.name |
| 풀스택 트레이스 연결 | trace context 전파(별도 gen_ai 식별자 없음) |
표의 마지막 항목인 풀스택 트레이스 연결이 특히 중요합니다. LLM 호출 한 건은 그 호출을 부른 백엔드 API, 함께 일어난 DB 조회, RAG라면 벡터 스토어 검색과 같은 흐름 안에 있습니다. GenAI Span을 상위 트랜잭션 트레이스의 한 단계로 놓고 보면, LLM 응답이 느릴 때 원인이 모델 자체인지 앞단 검색 단계인지 같은 화면에서 가려낼 수 있습니다.
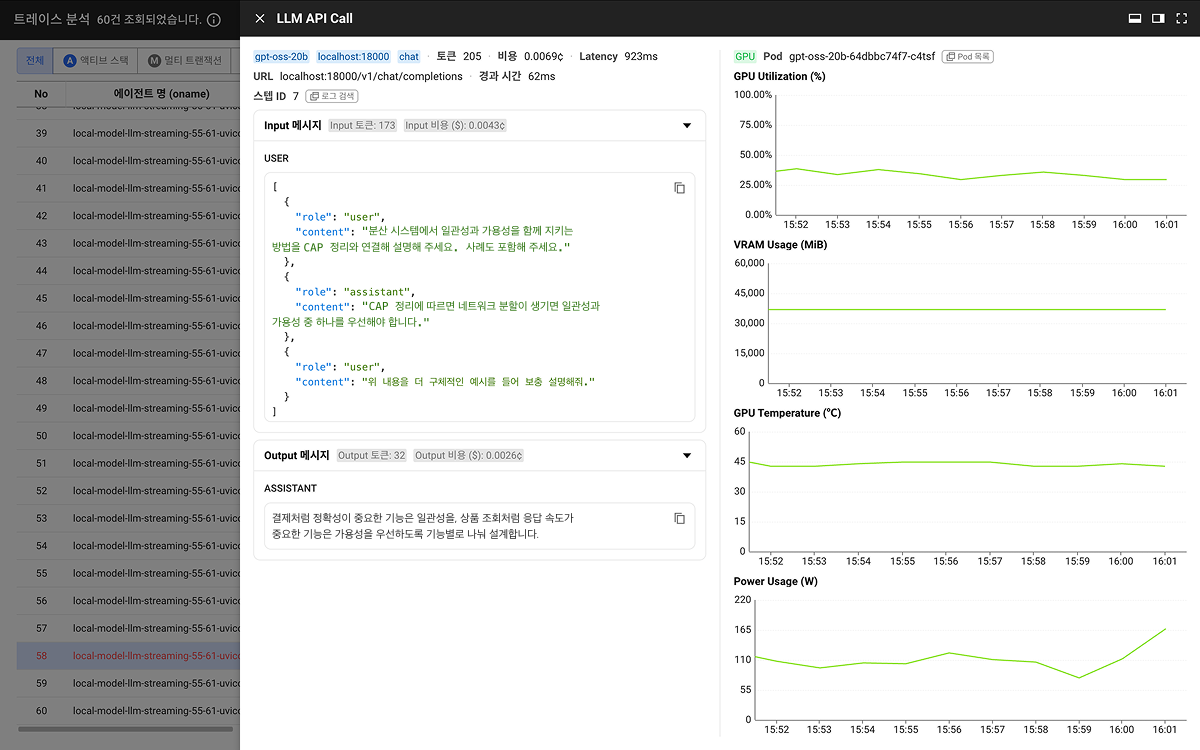 예시. 트랜잭션 안의 LLM 호출 단계를 열면 프롬프트, 토큰, 비용, 지연 시간과 그 시점의 GPU 지표가 함께 보입니다. 응답 지연이 모델 처리 문제인지 GPU 자원 병목인지 구분할 때 씁니다.
OTel GenAI 호환성을 확인하는 점검 질문 5개
LLM 옵저버빌리티 도구를 비교할 때, 다음 다섯 질문으로 OTel GenAI 호환 정도를 빠르게 가늠할 수 있습니다.
gen_ai.operation.name과gen_ai.provider.name을 표준 값으로 받아 그룹화하고 필터링할 수 있는가- 요청 모델과 응답 모델을 분리해서 보여주는가
- 토큰 데이터가 Span 속성과 메트릭 양쪽에 일관되게 들어가는가
- Opt-In 속성(시스템 프롬프트, 입출력 본문)에 권한 분리가 적용되는가
- LLM Span이 백엔드, 인프라 트레이스와 같은 트랜잭션 흐름으로 이어지는가
다섯 질문을 모두 충족하는지는 도구마다 차이가 크니, 제품 문서와 시연으로 직접 확인하는 편이 좋습니다. 표준을 받아들이는 정도와 풀스택 트레이스 통합 수준을 함께 보면 비교가 쉬워집니다.
자주 묻는 질문
OTel GenAI 시맨틱 컨벤션을 지금 계측에 써도 되나요?
개발 단계라 속성과 메트릭 이름이 바뀔 수 있습니다. 계측 라이브러리 버전을 고정해 두고, 버전을 올릴 때 규격 저장소의 변경 내역을 함께 확인하면 대시보드와 알림이 갑자기 비는 일을 줄일 수 있습니다.
토큰 비용은 Span 속성과 메트릭 가운데 어디서 집계하나요?
기간별 총량과 비용은 카운터 메트릭으로 집계하고, 특정 호출이 왜 비쌌는지는 Span의 토큰 속성으로 확인합니다.
프롬프트와 응답 본문을 수집하기 전에 무엇을 정해야 하나요?
Opt-In 속성을 켜기 전에 개인정보 마스킹 방식, 보존 기간, 본문을 볼 수 있는 사용자 범위를 먼저 정해 두는 편이 안전합니다.
마치며
OTel은 분산 트레이싱에서도 시장이 먼저 공통 규약을 쓰기 시작하고 표준 문서가 뒤따르는 순서를 거쳤습니다. GenAI 시맨틱 컨벤션도 같은 순서로 정리되고 있습니다. 분산 트레이싱 시기에 자체 포맷을 고집한 팀은 나중에 공통 규약으로 옮기면서 계측을 다시 해야 했고, LLM 계측에서도 같은 선택을 지금 하게 됩니다.
2026년 10월 현재 GenAI 시맨틱 컨벤션은 아직 개발 단계입니다. 그래도 운영자는 도구를 비교할 때도, 계측을 직접 설계할 때도 gen_ai.operation.name, gen_ai.provider.name, gen_ai.request.model, gen_ai.usage.input_tokens 같은 식별자를 그대로 보게 됩니다. 표준이 안정 단계가 되기 전에 gen_ai 식별자를 익혀 두면 도구를 바꾸거나 계측 범위를 넓힐 때 수집 코드를 다시 작성하는 일을 줄일 수 있습니다. LLM 호출 Span을 백엔드 API, DB 조회, 인프라 구간과 같은 트레이스로 이어 두면 응답이 느려졌을 때 원인 구간도 한 화면에서 찾을 수 있습니다.
와탭 AI Agent Observability에서는 LLM 호출을 애플리케이션 트랜잭션의 한 단계로 추적하고, LLM 호출을 처리한 GPU 인프라 지표도 같은 화면에서 함께 볼 수 있습니다. LLM 호출이 트랜잭션에 어떻게 이어지는지는 와탭 AI Agent Observability에서 확인할 수 있습니다.
더 읽을거리
- OpenTelemetry GenAI Semantic Conventions. 1차 출처. 2026년 6월부터 GenAI 규격을 관리하는 전용 저장소
- GenAI Spans. Span 속성 전체 목록과 Required, Recommended 분류
- GenAI Metrics. 지연 메트릭 정의
- GenAI Token Metrics. 토큰 카운터와 히스토그램 정의
- LLM 옵저버빌리티란 무엇인가. 이 글이 다루는 OTel 표준의 배경이 되는 개념과 필요성을 설명한 입문 편
- AI Agent Observability 소개 (와탭 공식 문서)